

Обучение языковых моделей и проблемы галлюцинаций
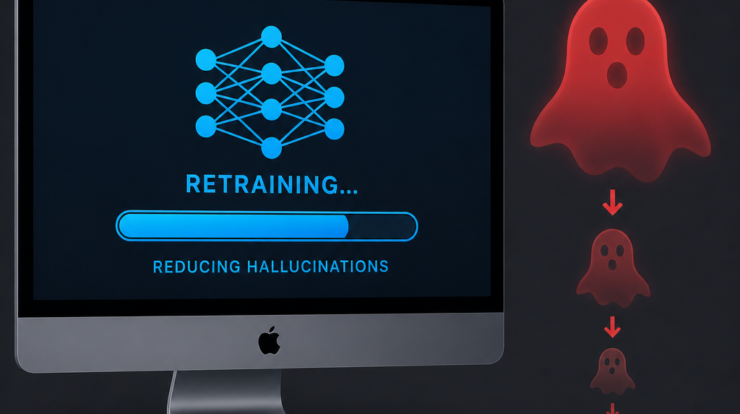
В наши дни обучение языковых моделей становится важной частью разработки искусственного интеллекта, и попытка дообучить малую модель Qwen3-0.6B на Mac для улучшения её ответов по данным, найденным с помощью семантического поиска, привлекла особое внимание. Задача кажется простой: используя имеющиеся фрагменты текста, дать модели возможность больше и точнее понимать контекст вопросов, чтобы она могла отвечать с большой степенью уверенности и точности. Однако, как это часто бывает в сложной среде машинного обучения, реальность преподнесла неожиданное.
Проблема, с которой столкнулись исследователи, заключалась в том, что первые попытки дообучения привели к негативным побочным эффектам. Вместо ожидаемого улучшения качества ответов, модель стала чаще выдавать вымышленные подробности. Это явление, известное как «галлюцинации» в языке машинного обучения, является одной из значительных проблем при работе с языковыми моделями. Важно отметить, что несмотря на увеличение числа галлюцинаций, validation loss — показатель, характеризующий, как модель справляется с обработкой обучающих данных, — продолжал снижаться. Это могло ввести исследователей в заблуждение, создавая иллюзию улучшения работы модели, в то время как на практике результаты ухудшались.
Процесс обучения языковых моделей требует тонкой настройки множества параметров и значительной работы с обучающими данными. В данном случае четыре версии обучающих данных были созданы и протестированы, чтобы глубже понять, почему происходит увеличение числа галлюцинаций. Анализ этих версий данных показал, какие изменения можно было бы внедрить для оптимизации работы модели. В результате удалось втрое сократить число галлюцинаций, но решение было достигнуто посредством компромисса: модель стала чаще отказываться от ответа, предпочитая молчание недостоверной информации.
Использование машинного обучения для улучшения языковых моделей приводит к грандиозным изменениям в обработке информации. Такие исследования важны не только с точки зрения науки, но и с точки зрения практического применения — от чат-ботов до ассистентов в различных индустриях. Подумайте, как часто мы сталкиваемся с необходимостью получить верный и точный ответ на наши вопросы. В повседневной жизни или на работе это может быть критически важным. Таким образом, качество ответов интеллектуальных систем напрямую влияет на эффективность и комфорт пользователей.
Представьте себе ситуацию, в которой вы обращаетесь к виртуальному ассистенту за важной информацией, например о медицинских рекомендациях или финансовых консультациях. В этих случаях неверный ответ или «вымысел» со стороны системы могут иметь серьёзные последствия. Поэтому снижение числа галлюцинаций, даже ценой частых отказов, имеет огромное значение: безопасность и надежность информации стоят на первом месте.
Эта новость подчеркивает важность внимательного подхода к каждому этапу работы с языковыми моделями, от выбора данных до интерпретации результатов. Для широкого круга пользователей важно осознавать, что модели ИИ остаются инструментами, работающими на основе обученных данных. Следовательно, совершенствование этих данных и алгоритмов так же важно, как и понимание их возможностей и ограничений.
Чтобы оценивать и внедрять результаты таких исследований, задайте себе вопрос: насколько велика необходимость в точных и проверяемых данных в вашей области? Как вы используете системы, основанные на языковых моделях, и способны ли они правильно интерпретировать и преподносить информацию? Каждый из нас должен уметь критически воспринимать технологические улучшения и адаптировать их с учетом потенциальных рисков и преимуществ.
Помните, что передовые технологии требуют принятия решений с учетом безопасности и пользы для конечного пользователя. Развитие языковых моделей, таких как Qwen3-0.6B, является лишь началом многолетнего процесса поиска идеального алгоритма, который бы балансировал между точностью и способностью интерпретировать информацию безопасно и эффективно. Будучи осведомленными пользователями, мы должны быть готовы как принимать прогресс, так и понимать его границы.
Полезные ссылки
- 💻 Виртуальный хостинг Sweb
- ⚙️ Автоматизация для бизнеса
- 📜 Сценарии по автоматизации
- 🖥️ Сервер для автоматизации
- 💳 Карты оплаты AI
- 🤖 Доступ к 500+ LLM из РФ
- 🌐 Интернет без цензуры
Наши соц. сети
- Telegram канал ProDelo
- Общий чат ProDelo
- Бесплатный курс по n8n
- Наш Youtube канал
- Наш Яндекс Дзен канал
- Наша группа в ВК